Seu primeiro modelo na typestrict, passo a passo
De uma planilha a um modelo que roda em qualquer CPU, em cinco passos e um crédito: o que cada tela pede, o que o agente faz por você, como o resultado é medido contra o Jev e o que você leva para casa.
Um modelo de decisão responde uma pergunta sobre um texto, do mesmo jeito, milhares de vezes por dia: qual time cuida deste chamado, este reembolso é legítimo, quão urgente é esta mensagem. Este guia treina um do zero, com as telas de um treino de verdade, para você saber o que esperar antes de gastar o seu primeiro crédito.
1. Traga os seus dados
Comece um treino e escolha de onde vêm os dados: seus próprios arquivos, um dataset público ou dados que o agente já estruturou em outro treino.
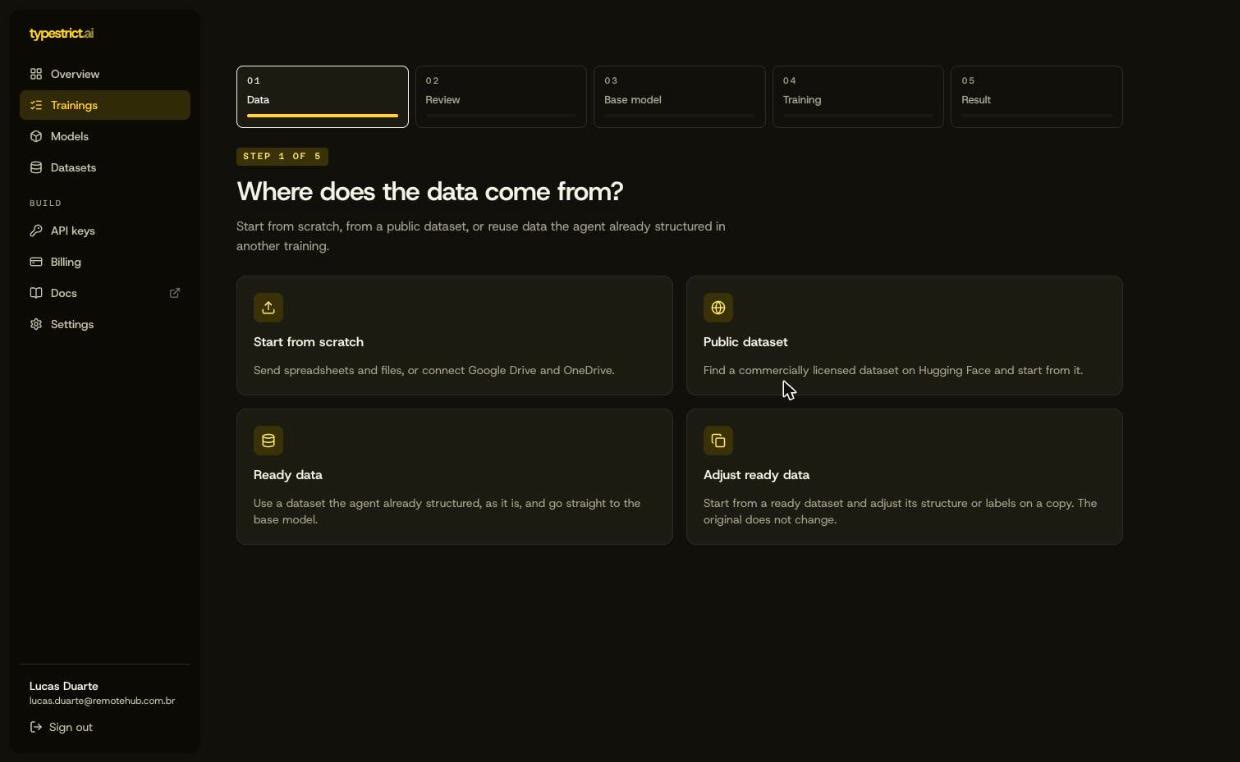
Depois escreva a decisão em uma frase. Essa frase é a entrada mais importante do treino inteiro: o agente lê os seus arquivos através dela. Encaminhe cada chamado para o time certo funciona; analise meus chamados não, porque não é uma pergunta com um conjunto fechado de respostas.
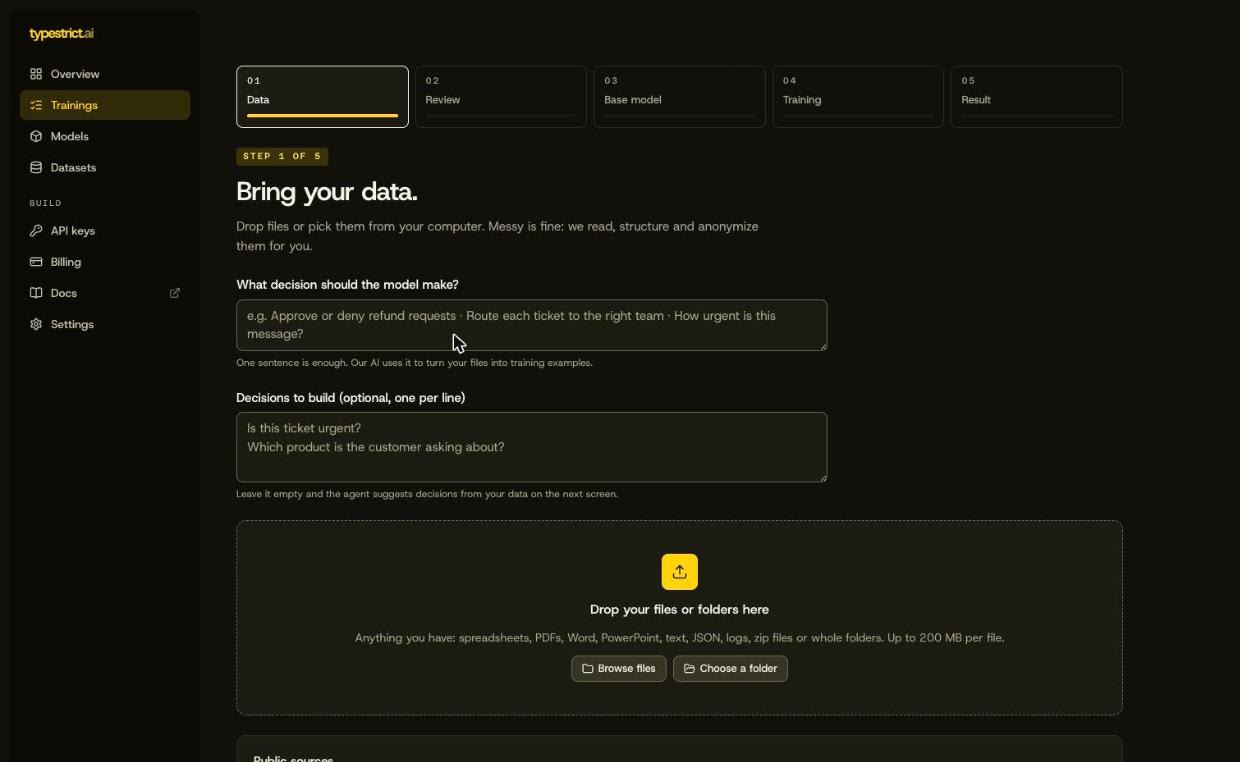
Para este guia usamos um dataset público: o Banking77, cerca de 10 mil mensagens que clientes mandaram para um banco, cada uma com uma de 77 intenções. Fontes públicas vêm do Hugging Face ou de um repositório público do GitHub, e só dá para escolher as que têm licença que permite uso comercial.
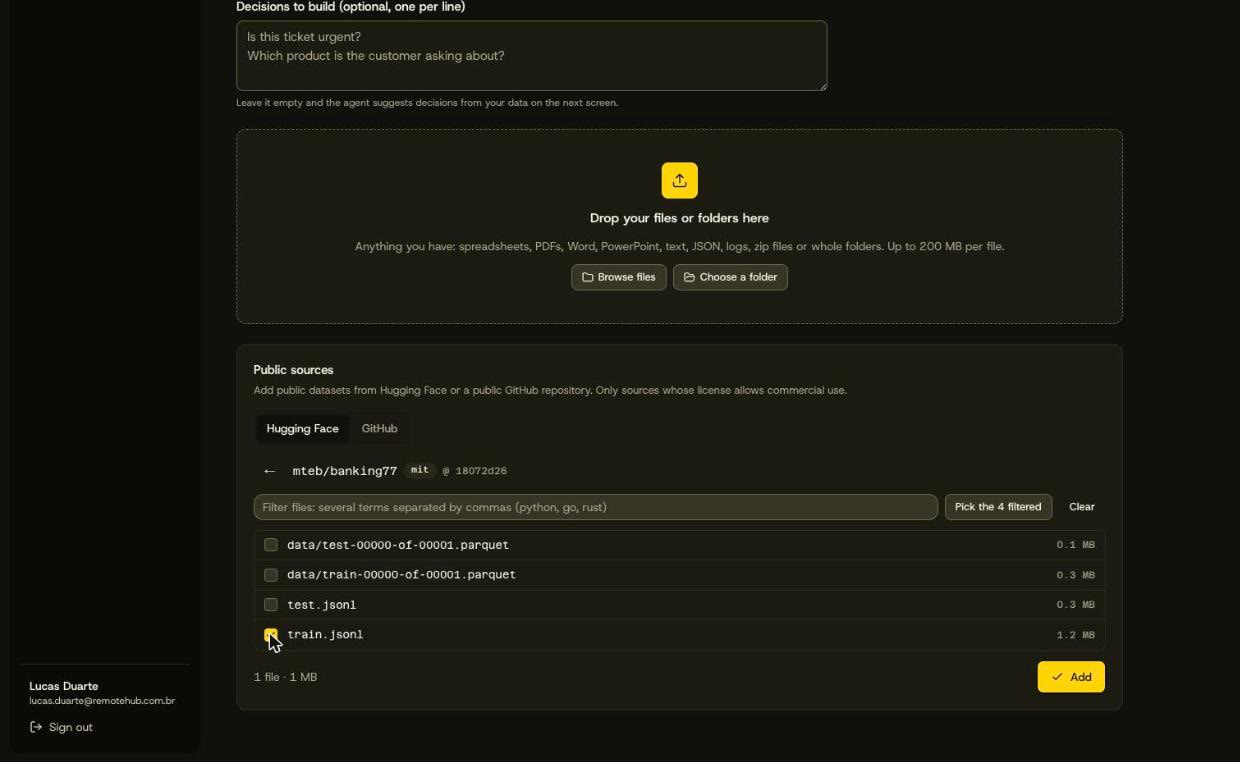
Tudo o que você manda é mascarado antes de qualquer modelo ler: nomes, e-mails, telefones, documentos e números de cartão. O upload original é apagado assim que a cópia mascarada existe.
2. Revise o que o agente propõe
Com os dados dentro, Estruturar meus dados pede à nossa IA para transformar os seus arquivos em exemplos de treino: o que o modelo lê, o que ele responde e de onde vem a resposta. Se você não tem certeza de qual decisão treinar, Sugerir decisões propõe algumas a partir dos dados primeiro.
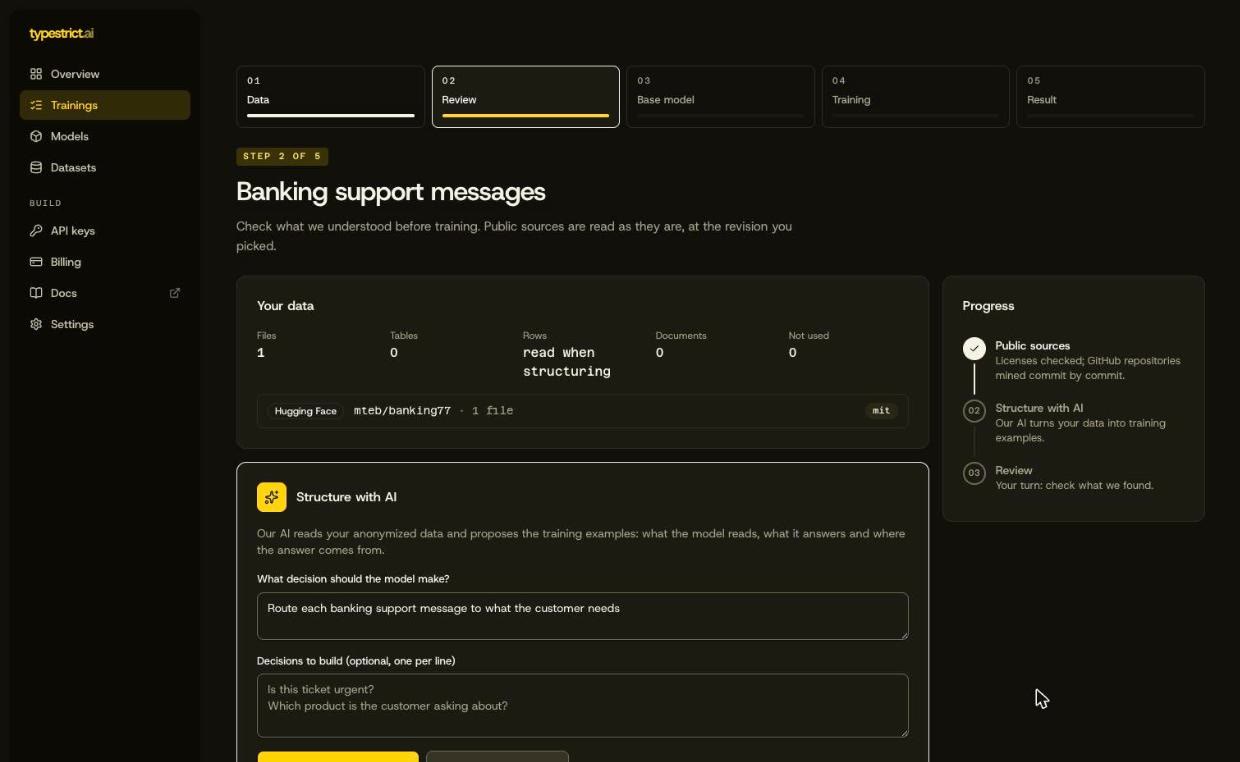
No Banking77 a proposta voltou em cerca de um minuto, com custo de IA de meio centavo de dólar. Leia como você leria o plano de um colega:
- A pergunta que o modelo vai responder, em palavras simples.
- De onde vem a resposta: uma coluna dos seus dados, ou exemplos que você vai rotular.
- Por que o agente escolheu essa estrutura, nas palavras dele.
- Respostas por opção: quantos exemplos cada resposta tem. Uma opção com pouquíssimos exemplos é uma que o modelo vai aprender mal; junte com outra ou traga mais dados.
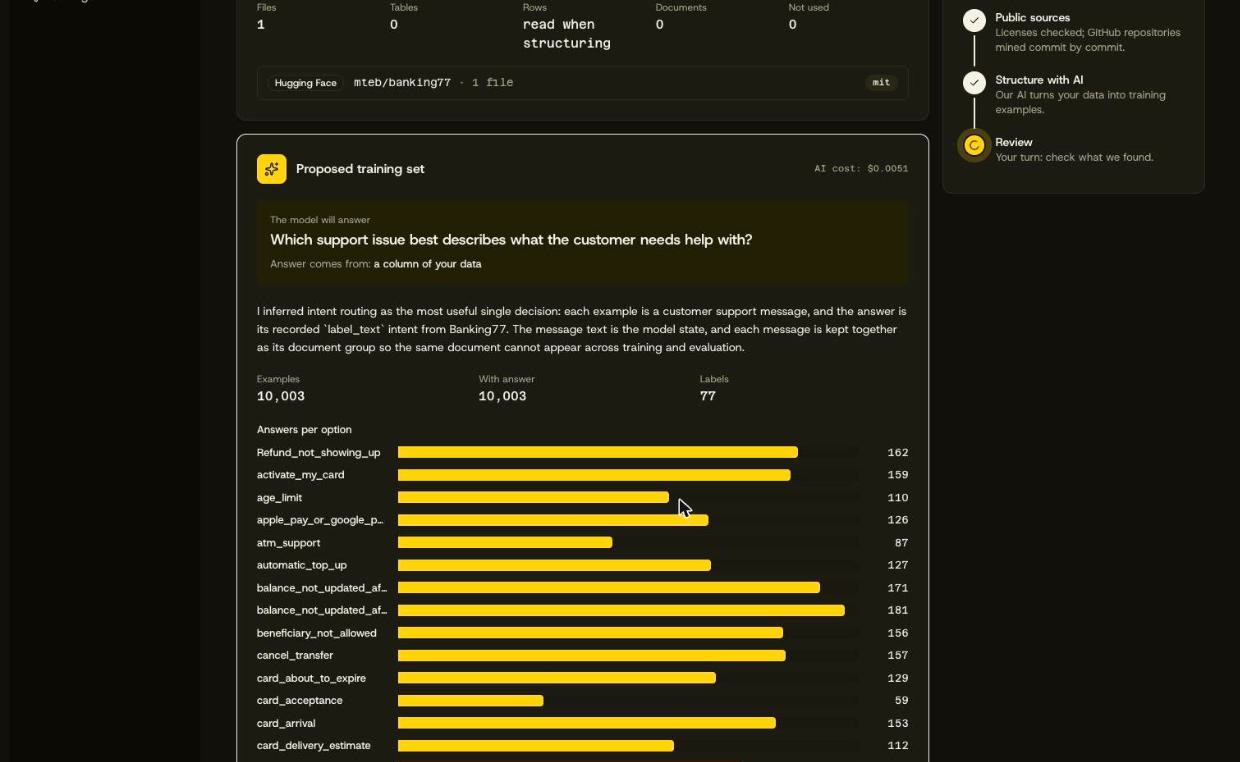
Se estiver certo, confirme. Se não, Ajustar recebe uma observação em palavras simples (use o assunto também, ignore notas internas, junte duas opções) e refaz a proposta com ela. Quando os seus dados ainda não têm respostas, o agente pré-rotula e pede para você responder uma amostra na mão: são esses exemplos que medem a garantia, então eles precisam ser seus.
3. Escolha um modelo base
Todo modelo base é nosso, aberto e liberado para uso comercial, e todos custam o mesmo crédito. O TS-moBERTo-150M é o padrão: lê inglês e português e serve para a maioria das tarefas. As bases Ettin menores respondem mais rápido e usam menos memória numa CPU, ao custo de alguma precisão quando há poucos exemplos.
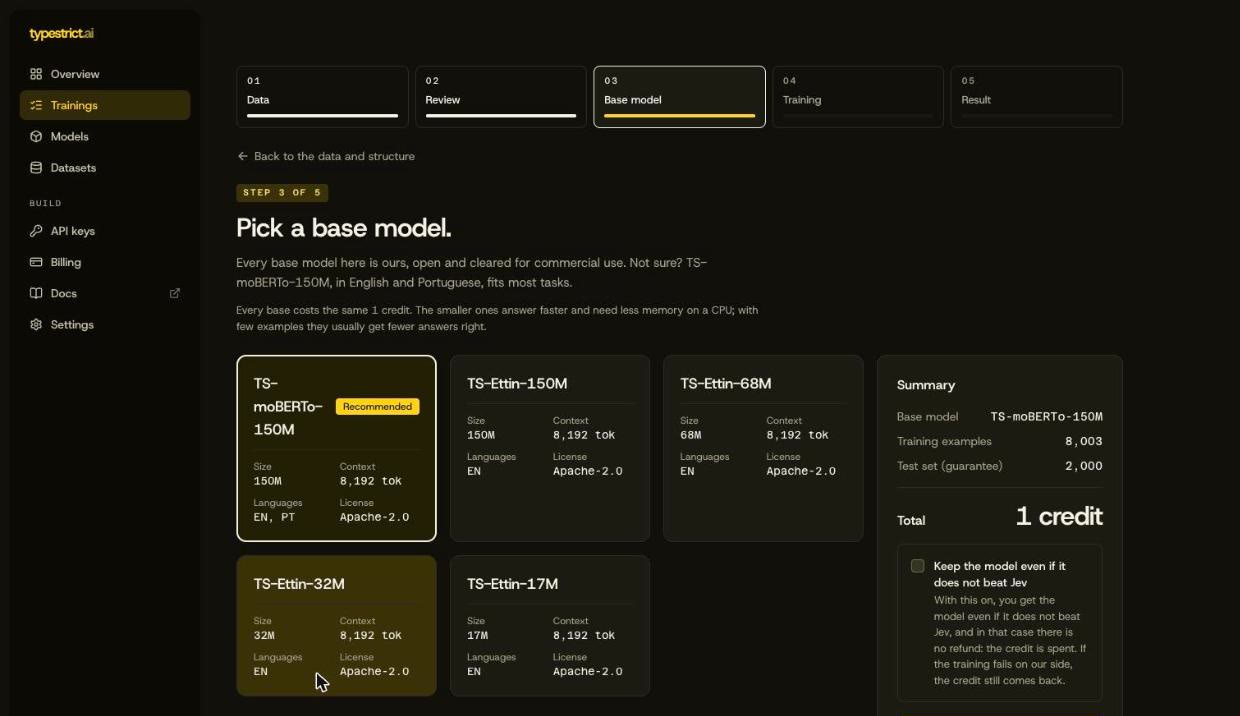
20% dos exemplos ficam separados e nunca aparecem no treino. O modelo e o Jev respondem exatamente esses, e a comparação decide o veredito. Por padrão, um modelo que não supera o Jev não é entregue e o crédito volta. Ficar com o modelo mesmo se não superar o Jev abre mão desse reembolso, em troca dos arquivos.
4. Treino
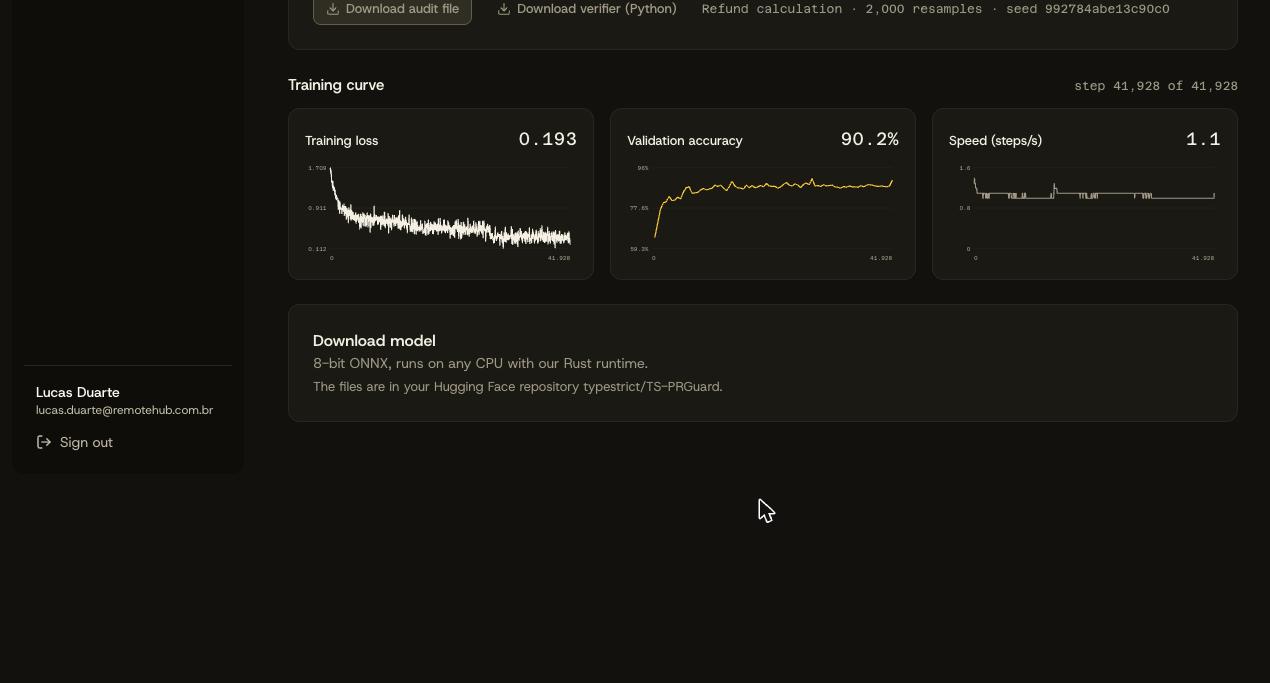
Começar o treino gasta o crédito. A página do treino mostra cada etapa ao vivo (preparo dos dados, a GPU, o treino, a comparação com o Jev) com a curva andando, e mandamos um e-mail quando termina. Pode fechar a aba. Se algo falhar do nosso lado, tentamos de novo sozinhos; se ainda falhar, o crédito volta na hora.
5. O resultado
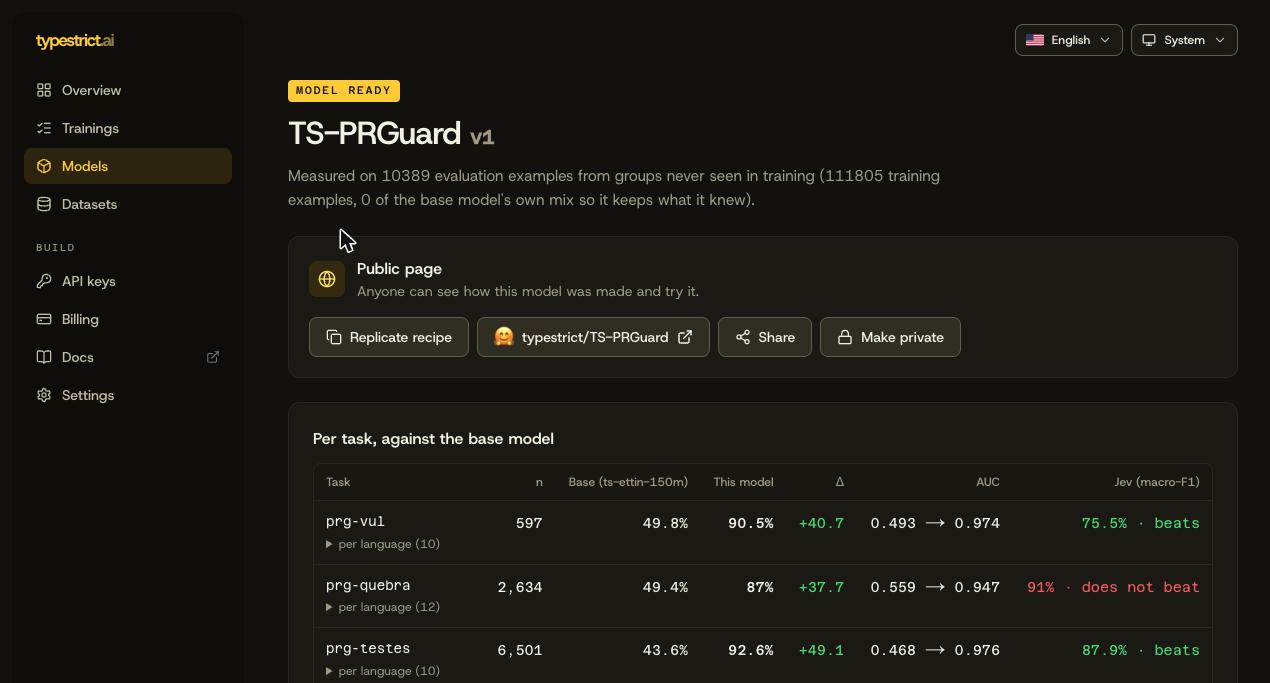
Um modelo pronto abre no resultado. Este é o TS-PRGuard, o modelo por trás do pr-guard, treinado do mesmo jeito: uma linha por pergunta, o modelo base antes do treino, o modelo treinado e o Jev nos mesmos exemplos separados.
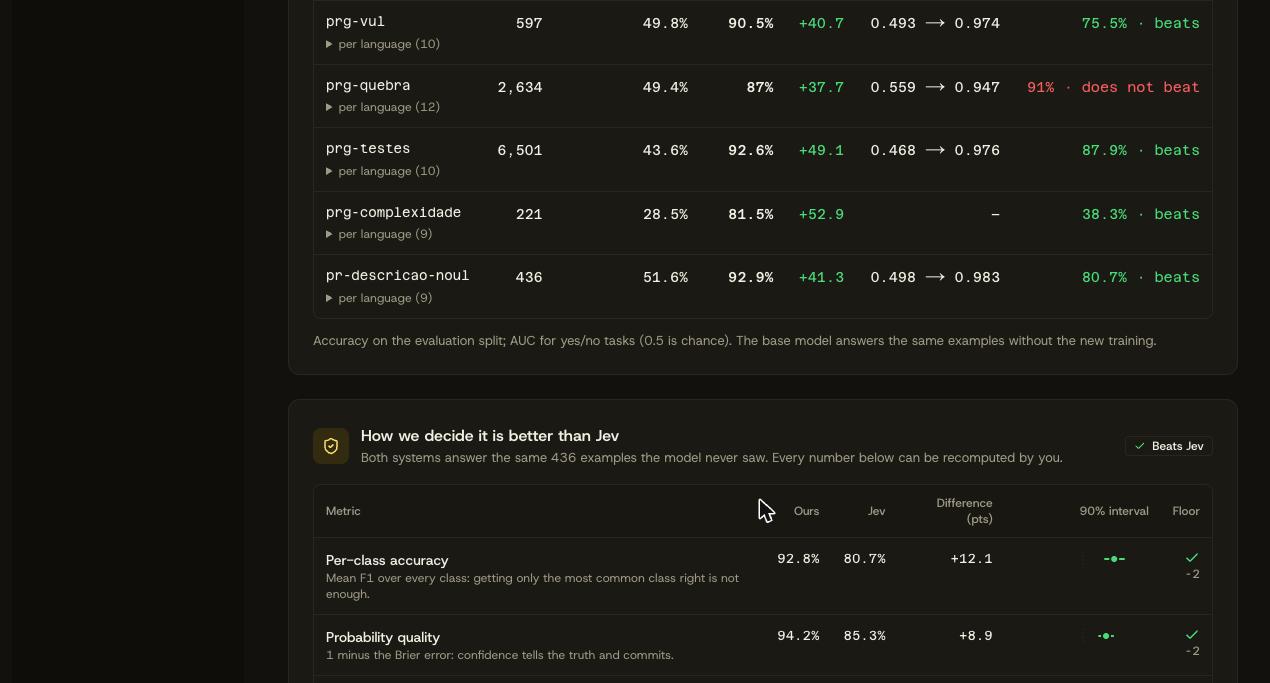
Logo abaixo, Como decidimos que é melhor que o Jev mostra cada métrica com o nosso valor, o do Jev, a diferença e o intervalo, e o piso que cada uma precisa passar. Não é um número de acurácia só: acertar apenas a resposta mais comum não basta, e as probabilidades também precisam ser honestas.
Depois, os arquivos. O modelo é um ONNX de 8 bits que roda em qualquer CPU, com o nosso runtime em Rust ou qualquer runtime ONNX, dentro da sua própria infraestrutura. Os arquivos ficam disponíveis por 30 dias; você também pode publicar o modelo na sua conta do Hugging Face e dar a ele uma página pública com playground.
Antes do seu primeiro crédito
- Escreva a decisão como uma pergunta com respostas fechadas. A maioria dos modelos fracos vem de uma pergunta vaga, não do modelo base.
- Olhe as respostas por opção. Menos de algumas dezenas de exemplos numa opção é um alerta; junte opções raras ou traga mais dados.
- Rotule a amostra você mesmo quando o agente pedir. Essas respostas são o juiz da garantia.
- Comece pela base recomendada. Teste uma menor depois, se precisar de velocidade na CPU.
- Leia o resultado por pergunta, não só o veredito. Ele mostra onde mais dados ajudariam mais.
Dúvidas sobre os seus próprios dados? Escreva para contact@typestrict.ai, ou comece um treino em typestrict.ai.