Machine learning para todos: uma IA especializada nos dados do seu negócio
Hoje abrimos a typestrict.ai. Você envia os exemplos das decisões que a sua empresa já toma, nós treinamos um modelo só seu, mostramos o quanto ele acerta em casos que ele nunca viu, e ele vai rodar onde você quiser.
Treinar uma IA própria ainda é coisa de quem sabe treinar IA. Não deveria ser.
Para ter um modelo de machine learning feito para o seu negócio, hoje você precisa de alguém que saiba preparar dados, escolher um modelo, treinar, medir e colocar em produção. É conhecimento raro, infraestrutura cara e semanas de trabalho. Por isso a maioria das empresas acaba alugando um modelo genérico, pagando por cada pergunta, para tarefas que ele nunca aprendeu do jeito delas.
A typestrict.ai existe para mudar isso. Machine learning para todos: qualquer pessoa com os dados certos treina um modelo próprio, sabe com números o quanto ele é bom, e leva o modelo para casa.
Sua empresa já tem o que precisa
Todo dia a sua empresa toma decisões repetidas. Para qual time vai este chamado. Qual é o assunto desta mensagem. Esta cláusula está no contrato ou não. Este pedido merece uma segunda olhada. E cada decisão dessas, tomada por alguém do seu time, ficou registrada em algum lugar: numa planilha, num sistema de atendimento, numa pasta de documentos.
Esses registros são exemplos. E exemplos são exatamente o que um modelo precisa para aprender a decidir como a sua empresa decide, com as suas categorias, os seus nomes, o seu jeito.
Como funciona
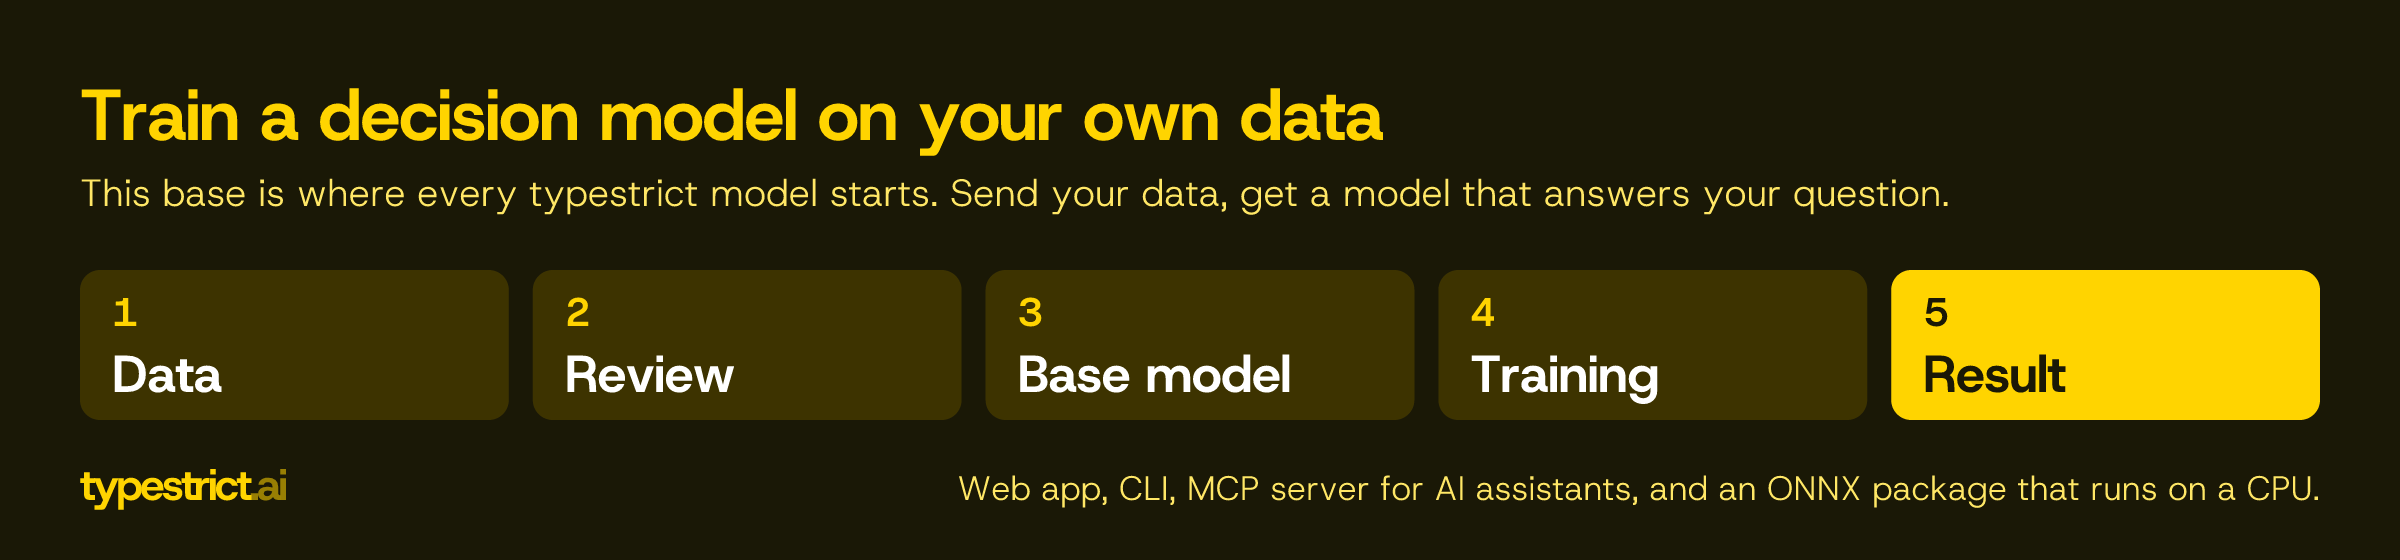
- 1. Dados. Você envia uma planilha, uma pasta de documentos ou um conjunto público. Antes de qualquer coisa ler os arquivos, mascaramos nomes, e-mails, telefones, documentos como CPF e CNPJ e números de cartão, e apagamos o original.
- 2. Revisão. Um agente lê os dados e propõe a decisão: a pergunta, as respostas possíveis e quantos exemplos há de cada uma. Você confere e ajusta em português, sem código. Se os seus dados ainda não têm as respostas, você responde uma amostra de casos e o resto é rotulado para você.
- 3. Modelo base. Você escolhe de qual modelo partir. Na dúvida, o padrão já serve.
- 4. Treino. Treinamos o modelo nos seus exemplos, numa GPU que existe só durante o treino.
- 5. Resultado. Você vê o quanto ele acerta e baixa o modelo.
Tudo isso dá para fazer no site, ou pedindo ao seu assistente de IA (ChatGPT, Claude, Cursor e outros) pelo nosso servidor MCP.
Não basta treinar. É preciso saber se funciona
Antes do treino, separamos 20% dos seus exemplos e escondemos do modelo. Depois, medimos o modelo nesses casos que ele nunca viu e colocamos o resultado lado a lado com o Jev, um modelo de referência do mercado, nos mesmos exemplos. Você não precisa acreditar em nós: o resultado vem com os números, e a conta pode ser refeita por qualquer pessoa.
Um caso real, rodado no produto como um cliente rodaria: o BANKING77, uma base pública de mensagens de clientes de banco, com 77 assuntos diferentes.
Nem toda tarefa termina assim. Em temas genéricos, que um modelo grande já conhece bem, ele pode empatar ou ganhar do nosso. Por isso a regra é simples: se o seu modelo não superar o Jev pelos critérios publicados, o crédito volta. Você só paga por um modelo que provou ser melhor na sua tarefa. A regra completa está no cálculo de reembolso.
Um modelo seu, rodando onde você quiser
O que você baixa é o modelo inteiro, num arquivo de menos de 200 MB que roda na CPU: no seu servidor, num container, no navegador ou dentro de um aplicativo. Não existe cobrança por pergunta: depois de baixado, um milhão de decisões custa o mesmo que uma, e cada pergunta não precisa sair da sua infraestrutura.
- Cada resposta vem com uma confiança. Você automatiza os casos em que o modelo está seguro e manda o resto para uma pessoa.
- Os seus dados têm prazo. Os arquivos do modelo ficam para download por 30 dias, e os dados de um treino são apagados depois de 90 dias sem uso. Detalhes em retenção.
- Para integrar, há documentação, um CLI e o pacote decision_ai para Flutter.
Por trás do produto, uma nova família de modelos
O seu modelo não começa do zero. Ele parte de um modelo base que já sabe ler e decidir: a família TS, cinco modelos abertos que nós treinamos para escolher entre opções em vez de escrever texto. Veja um deles respondendo, sem nenhum treino nos seus dados:
Qual é o assunto da mensagem do cliente?
“Meu cartão ainda não chegou. Como posso acompanhar a entrega?”
- Problema com pagamento<0,1%
- Entrega do cartão100%
- Cancelamento<0,1%
confiança 0,98
Os modelos TS são abertos e qualquer pessoa pode baixar e testar. Como eles funcionam, os benchmarks e o código estão no artigo técnico: Família TS: modelos de decisão que você treina nos seus dados.
Experimente com os seus dados
Para começar, você precisa de uma coisa: exemplos de uma decisão que a sua empresa toma. Uma planilha com uma linha por caso e, de preferência, a resposta que foi dada. Centenas de exemplos por resposta é o ideal, mas dá para começar com menos.
Se você tem uma tarefa e não sabe se ela cabe aqui, me escreve. Machine learning para todos começa por ouvir quem nunca treinou um modelo.