Tu primer modelo en typestrict, paso a paso
De una hoja de cálculo a un modelo que corre en cualquier CPU, en cinco pasos y un crédito: qué pide cada pantalla, qué hace el agente por ti, cómo se mide el resultado contra Jev y qué te llevas.
Un modelo de decisión responde una pregunta sobre un texto, de la misma forma, miles de veces al día: qué equipo atiende este ticket, si este reembolso es legítimo, qué tan urgente es este mensaje. Esta guía entrena uno desde cero, con las pantallas de un entrenamiento real, para que sepas qué esperar antes de gastar tu primer crédito.
1. Trae tus datos
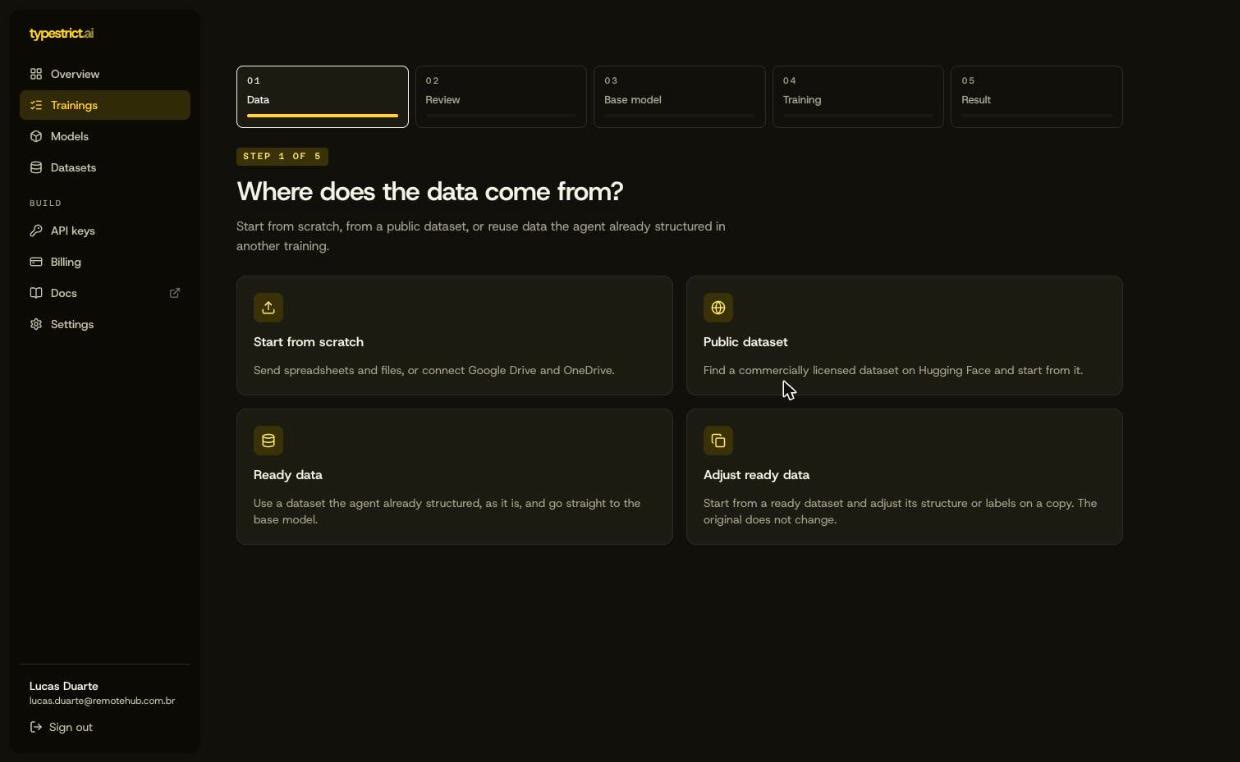
Empieza un entrenamiento y elige de dónde vienen los datos: tus propios archivos, un dataset público o datos que el agente ya estructuró en otro entrenamiento.
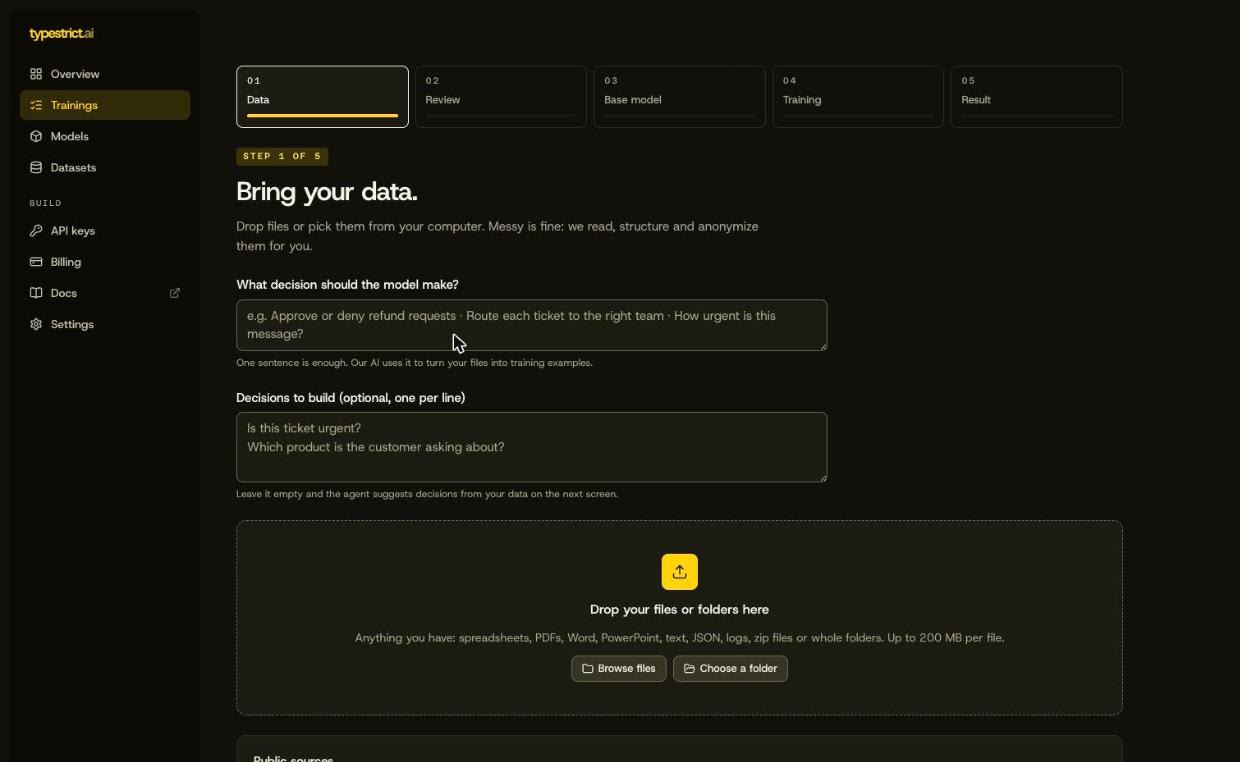
Luego escribe la decisión en una frase. Esa frase es la entrada más importante de todo el entrenamiento: el agente lee tus archivos a través de ella. Enruta cada ticket al equipo correcto funciona; analiza mis tickets no, porque no es una pregunta con un conjunto cerrado de respuestas.
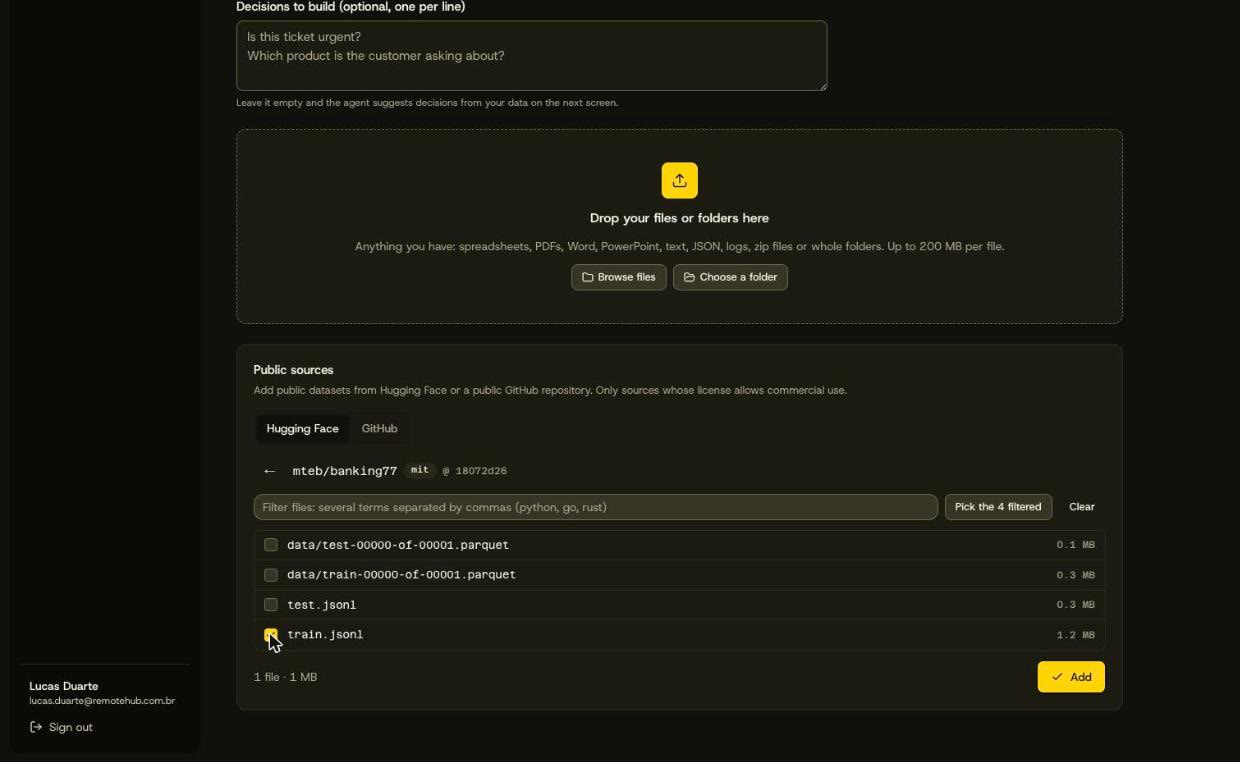
Para esta guía usamos un dataset público: Banking77, unos 10.000 mensajes que clientes enviaron a un banco, cada uno con una de 77 intenciones. Las fuentes públicas vienen de Hugging Face o de un repositorio público de GitHub, y solo se pueden elegir las que tienen una licencia que permite uso comercial.
Todo lo que envías se enmascara antes de que cualquier modelo lo lea: nombres, correos, teléfonos, documentos y números de tarjeta. La subida original se borra en cuanto existe la copia enmascarada.
2. Revisa lo que propone el agente
Con los datos dentro, Estructurar mis datos le pide a nuestra IA que convierta tus archivos en ejemplos de entrenamiento: qué lee el modelo, qué responde y de dónde viene la respuesta. Si no estás seguro de qué decisión entrenar, Sugerir decisiones propone algunas a partir de los datos primero.
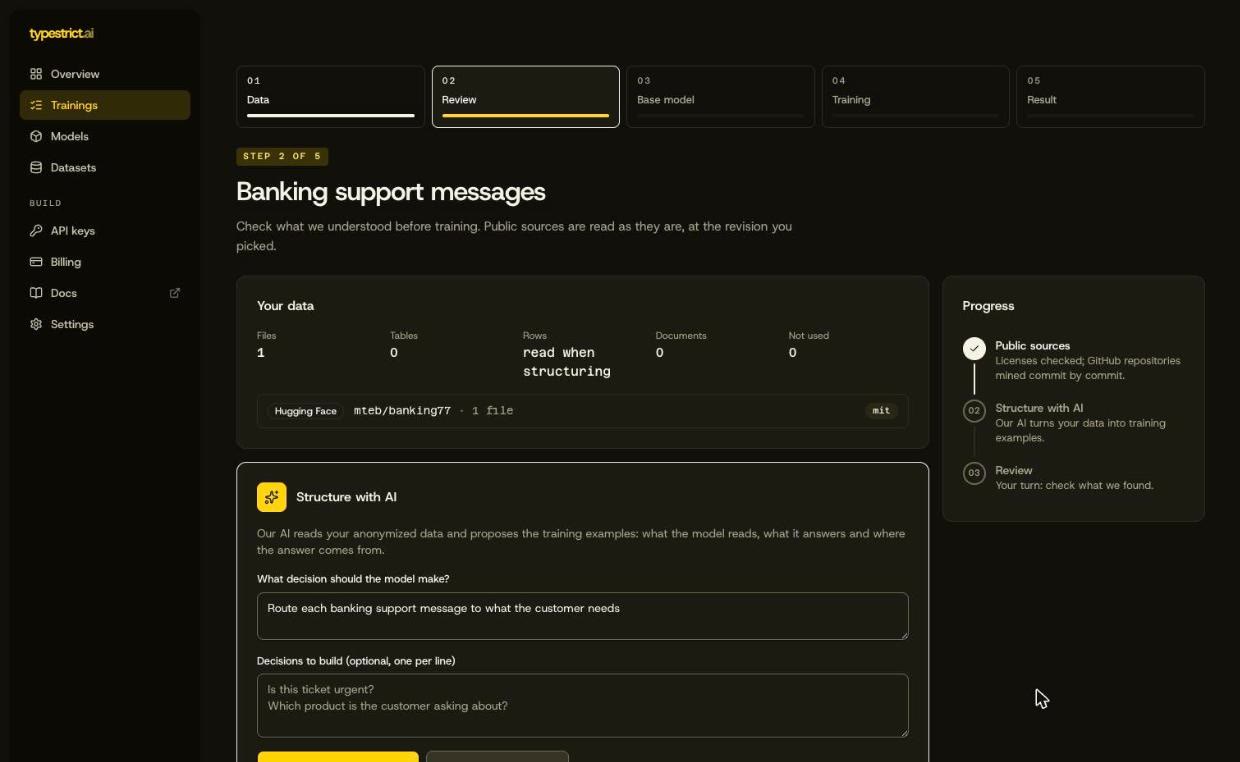
En Banking77 la propuesta volvió en cerca de un minuto, con un costo de IA de medio centavo de dólar. Léela como leerías el plan de un colega:
- La pregunta que el modelo va a responder, en palabras simples.
- De dónde viene la respuesta: una columna de tus datos, o ejemplos que vas a etiquetar.
- Por qué el agente eligió esta estructura, en sus propias palabras.
- Respuestas por opción: cuántos ejemplos tiene cada respuesta. Una opción con muy pocos ejemplos es una que el modelo aprenderá mal; únela con otra o trae más datos.
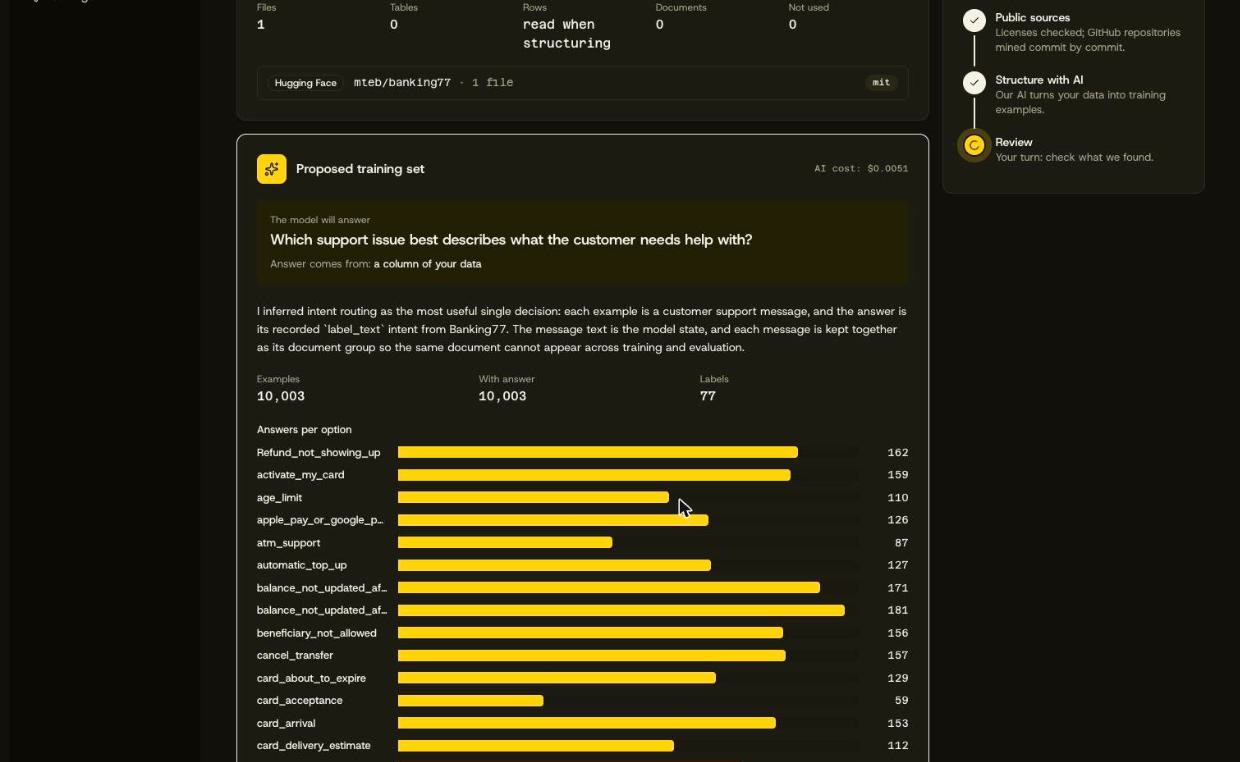
Si está bien, confirma. Si no, Ajustar recibe una nota en palabras simples (usa también el asunto, ignora las notas internas, une dos opciones) y rehace la propuesta con ella. Cuando tus datos aún no tienen respuestas, el agente pre-etiqueta y te pide que respondas una muestra a mano: esos son los ejemplos que miden la garantía, así que deben ser tuyos.
3. Elige un modelo base
Todos los modelos base son nuestros, abiertos y aptos para uso comercial, y todos cuestan el mismo crédito. TS-moBERTo-150M es el predeterminado: lee inglés y portugués y sirve para la mayoría de las tareas. Las bases Ettin más pequeñas responden más rápido y usan menos memoria en una CPU, a costa de algo de precisión cuando hay pocos ejemplos.
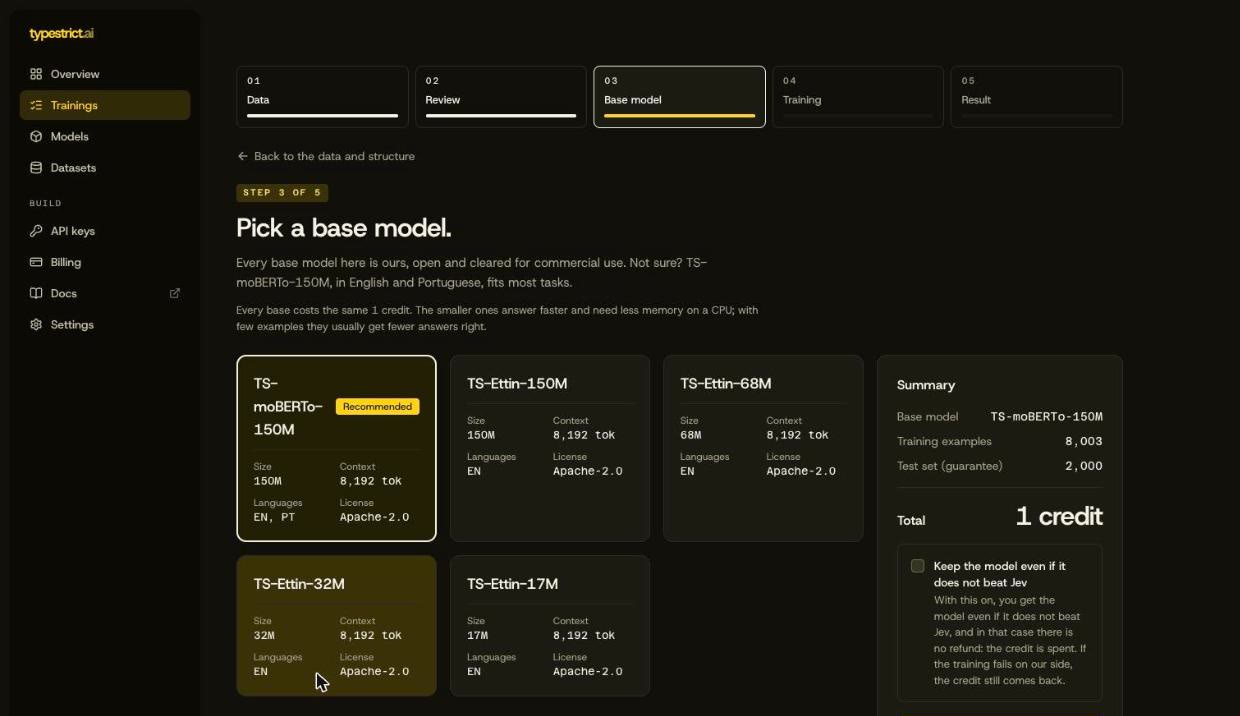
El 20% de los ejemplos queda apartado y nunca aparece en el entrenamiento. El modelo y Jev responden exactamente esos, y la comparación decide el veredicto. Por defecto, un modelo que no supera a Jev no se entrega y el crédito vuelve. Quedarme con el modelo aunque no supere a Jev renuncia a ese reembolso, a cambio de los archivos.
4. Entrenamiento
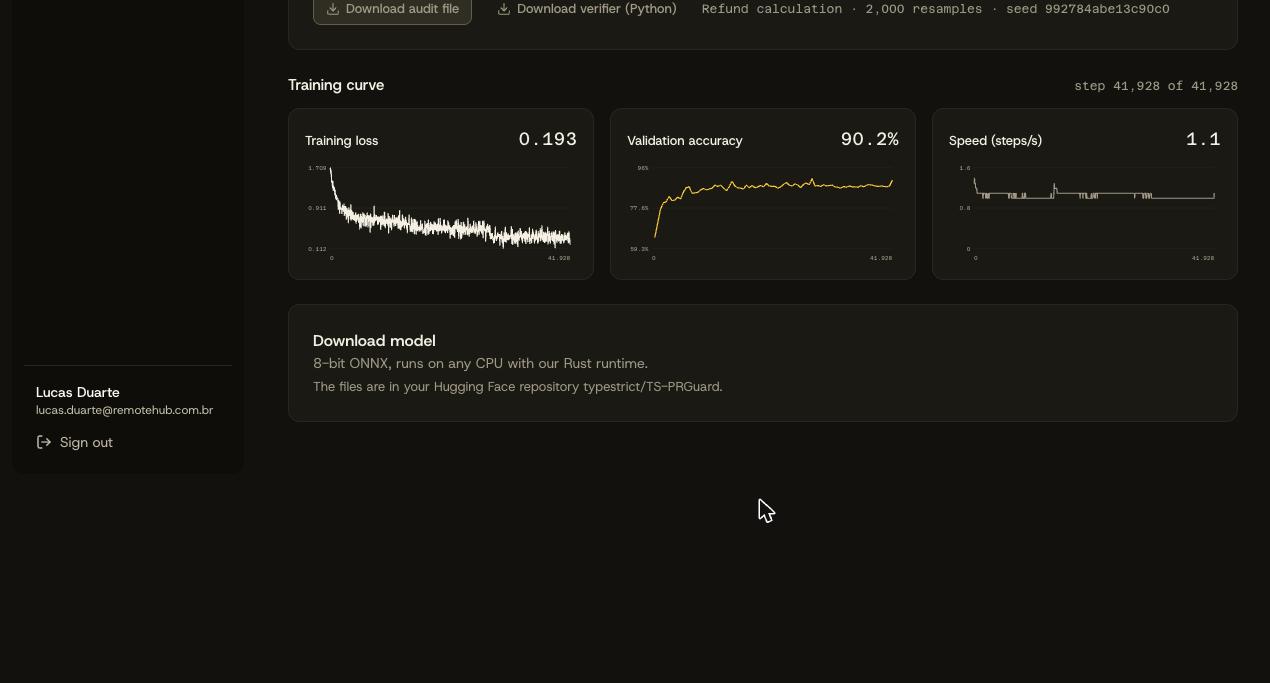
Empezar el entrenamiento gasta el crédito. La página del entrenamiento muestra cada etapa en vivo (preparación de los datos, la GPU, el entrenamiento, la comparación con Jev) con la curva avanzando, y te enviamos un correo cuando termina. Puedes cerrar la pestaña. Si algo falla de nuestro lado, lo intentamos de nuevo solos; si aun así falla, el crédito vuelve al instante.
5. El resultado
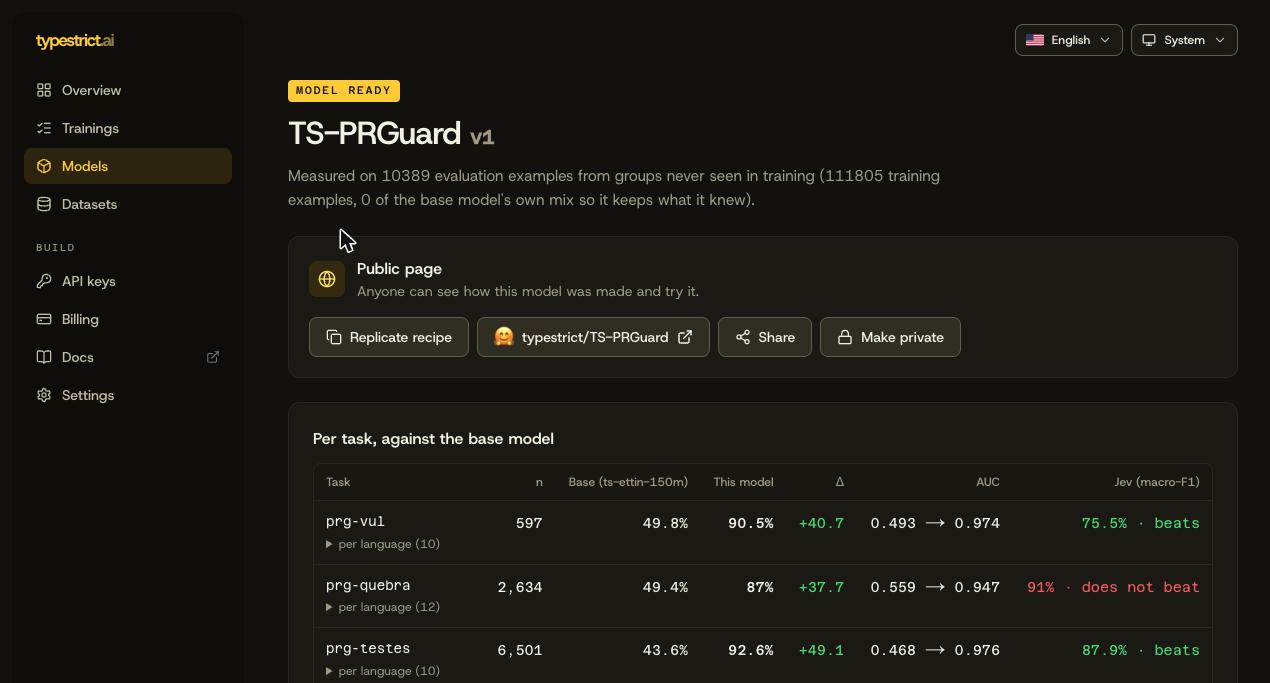
Un modelo terminado abre en su resultado. Este es TS-PRGuard, el modelo detrás de pr-guard, entrenado de la misma forma: una fila por pregunta, el modelo base antes del entrenamiento, el modelo entrenado y Jev en los mismos ejemplos apartados.
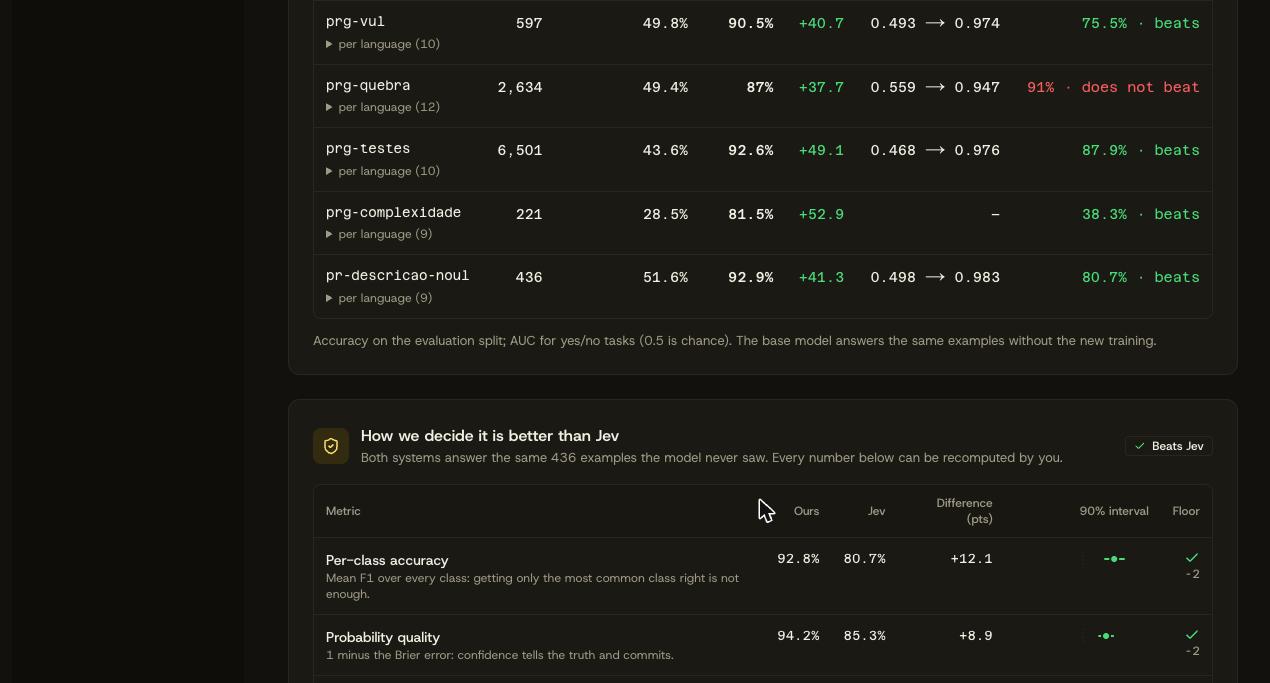
Debajo, Cómo decidimos que es mejor que Jev muestra cada métrica con nuestro valor, el de Jev, la diferencia y su intervalo, y el piso que cada una debe superar. No es un único número de exactitud: acertar solo la respuesta más común no basta, y las probabilidades también deben ser honestas.
Luego, los archivos. El modelo es un ONNX de 8 bits que corre en cualquier CPU, con nuestro runtime en Rust o cualquier runtime ONNX, dentro de tu propia infraestructura. Los archivos quedan disponibles 30 días; también puedes publicar el modelo en tu cuenta de Hugging Face y darle una página pública con playground.
Antes de tu primer crédito
- Escribe la decisión como una pregunta con respuestas cerradas. La mayoría de los modelos flojos vienen de una pregunta vaga, no del modelo base.
- Mira las respuestas por opción. Menos de unas decenas de ejemplos en una opción es una alerta; une opciones raras o trae más datos.
- Etiqueta la muestra tú mismo cuando el agente lo pida. Esas respuestas son el árbitro de la garantía.
- Empieza por la base recomendada. Prueba una más pequeña después si necesitas velocidad en la CPU.
- Lee el resultado por pregunta, no solo el veredicto. Te dice dónde más datos ayudarían más.
¿Dudas sobre tus propios datos? Escríbenos a contact@typestrict.ai, o empieza un entrenamiento en typestrict.ai.