pr-guard: ¿cuántas personas deben revisar este pull request?
Hoy abrimos pr-guard, una verificación open source que ejecuta un modelo de 150M parámetros en el runner de tu propio CI y, con una política en YAML que escribe tu equipo, decide si un pull request necesita cero, uno o dos revisores, o si debe bloquearse.
Un pull request de una línea y otro de dos mil no deberían esperar el mismo número de revisores.
Todo equipo de ingeniería conoce los dos extremos de la misma regla: el PR de una línea que cambia un texto y espera dos días por dos aprobaciones, y el PR enorme que toca la autenticación y pasa con un "LGTM" en cinco minutos. "Todo PR necesita N revisores" es fácil de escribir y difícil de cumplir, porque trata igual cambios que no se parecen en nada.
La pregunta que queríamos responder es más modesta que "revisa mi código": ¿cuántas personas necesitan mirar este pull request? Ninguna, una o dos. O, cuando haga falta, ningún merge hasta que alguien lo mire con calma. Nuestra respuesta es pr-guard, open source bajo Apache-2.0, y la versión v0.1.0 sale hoy. No es un escáner ni un agente de code review: es una capa de gobernanza que decide cuánta atención merece cada cambio.
Qué hace
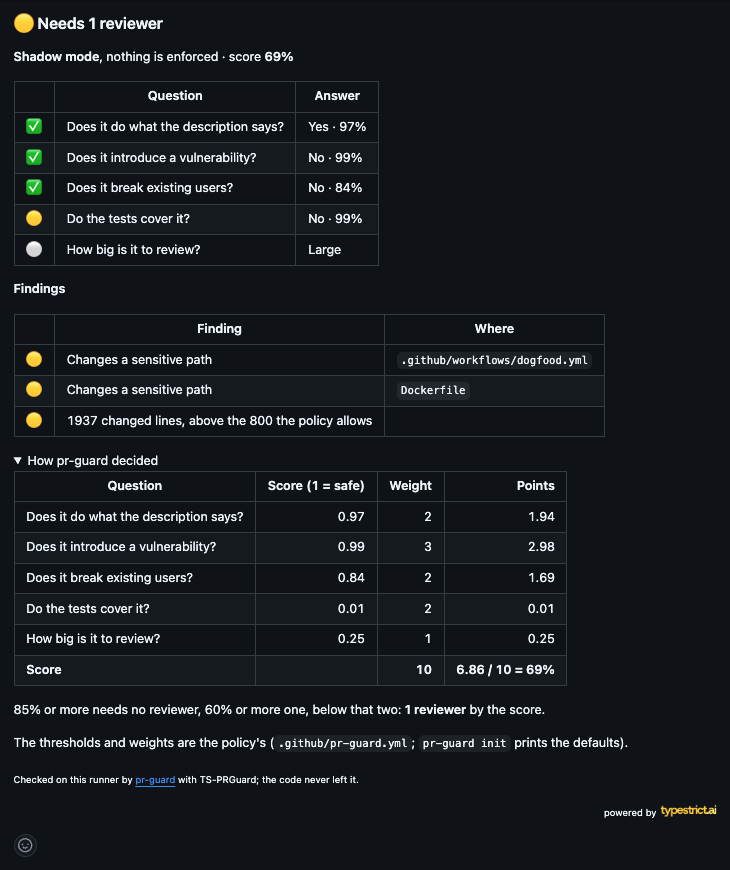
pr-guard lee el diff y la descripción del pull request y le hace cinco preguntas a TS-PRGuard, en una sola pasada:
- Descripción: ¿el cambio hace lo que dice la descripción?
- Vulnerabilidad: ¿introduce una vulnerabilidad de seguridad?
- Breaking change: ¿rompe a quienes ya usan este código?
- Tests: ¿los tests del cambio cubren lo que cambió?
- Tamaño: ¿qué tan grande es para revisar, de trivial a muy grande?
TS-PRGuard v1 se entrenó y se evaluó con pull requests descritos en inglés, con código en 11 lenguajes: JavaScript, TypeScript, Python, Go, Rust, Java, Kotlin, Swift, Dart, PHP y Ruby. El código en cualquier otro lenguaje queda marcado como "not evaluated", y la política lo trata con cuidado (más abajo).
Junto a eso corren reglas deterministas, sin ningún modelo: secretos en el diff, SQL destructivo, rutas sensibles (workflows de CI, auth, migrations, Dockerfiles, Terraform, .env), cambios grandes y dependencias. Las respuestas del modelo forman una nota ponderada, y una política en YAML versionada junto a tu código decide: cero, uno o dos revisores, o bloqueado.
Después pr-guard escribe tres cosas en el pull request: un comentario fijo (creado una vez y editado en cada push), labels y un status pr-guard que puedes hacer obligatorio. Funciona con GitHub, GitLab y Bitbucket, y corre en GitHub Actions, GitLab CI, Bitbucket Pipelines, CircleCI, Bitrise, Jenkins, pre-commit o cualquier shell. Dónde vive el pull request y dónde corre el job son preguntas separadas: un job de Jenkins puede revisar un pull request de GitHub.
Las premisas
- El código nunca sale del runner. El modelo corre en la CPU del propio CI: sin API, sin clave, sin GPU, sin telemetría. Las únicas llamadas que hace pr-guard son la descarga del modelo y el comentario, las labels y el status en tu propio host.
- Lo bastante rápido para cada pull request, sin cola.
- Decide la política de tu equipo, no el modelo. El modelo da probabilidades; umbrales, pesos y lo que bloquea viven en un archivo junto a tu código.
- Funciona donde ya está tu código, sin cambiar de host ni de CI.
- Empieza sin estorbar. Nadie debería tener un merge bloqueado por una herramienta que acaba de instalar.
¿Por qué no enviar el diff a un LLM grande? Porque eso rompe la primera premisa: el código saldría de tu infraestructura, con una clave de API en medio y una factura por llamada. Para responder cinco preguntas cerradas sobre un diff, basta un modelo pequeño entrenado exactamente en esas preguntas, y es la misma idea detrás de todo modelo entrenado en typestrict.ai.
Cuánto cuesta ejecutarlo
Medido en el pull request del propio pr-guard, en un runner ubuntu-latest estándar de GitHub: 11 segundos y 460 MB con 48 líneas cambiadas (contando la primera descarga del modelo), 23 segundos y 650 MB con 52 líneas de Rust, y de 23 a 71 segundos y 1,9 GB de 382 a 1.937 líneas, el pull request de la imagen de arriba (los 71 segundos incluyen volver a descargar el modelo). pr-guard es un único binario en Rust con ONNX Runtime dentro, sin sidecar y sin nada que alojar.
El modelo es su única dependencia externa. pr-guard descarga TS-PRGuard una vez desde Hugging Face, fijado a un commit y verificado archivo por archivo contra su SHA-256, y la caché del CI lo guarda. Donde los runners no tienen internet, sirve los mismos archivos desde un mirror, un CDN o un directorio, o usa la imagen Docker, que ya trae el modelo dentro.
El modelo, frente a Jev
TS-PRGuard se entrenó con typestrict.ai, igual que un cliente entrena un modelo, sobre el dataset TS-PRGuard, a partir de TS-Ettin-150M. De 124.194 ejemplos etiquetados, 10.389 se apartaron antes del entrenamiento para compararlo con Jev, el modelo de referencia del mercado, en los mismos ejemplos.
Se apartaron por repositorio, no por ejemplo. Cada uno de los 8.355 repositorios de los datos fue entero a un lado, cerca de uno de cada diez a la evaluación, el mismo en todas las preguntas, así que el modelo se mide en proyectos que nunca vio. Los duplicados se quitaron, y los ejemplos de entrenamiento que repiten contenido de la evaluación (forks, archivos copiados) se retiraron antes del entrenamiento. La comparación con Jev usa todos los ejemplos apartados de descripción, tamaño y vulnerabilidad, y un sorteo de 2.000 en breaking change y tests. Siguen siendo proyectos públicos de las mismas fuentes, no tu código: los proyectos de ejemplo y el shadow mode, más abajo, son cómo lo compruebas en el tuyo.
| Pregunta | Ejemplos apartados | TS-PRGuard | Jev | Ganancia (IC 95%) | Resultado |
|---|---|---|---|---|---|
| ¿Hace lo que dice la descripción? | 436 | 0,928 | 0,807 | +0,109 [+0,078; +0,141] | le gana a Jev |
| ¿Qué tan grande es para revisar? | 221 | 0,660 | 0,383 | +0,196 [+0,131; +0,248] | le gana a Jev |
| ¿Rompe a quienes ya lo usan? | 2.000 | 0,870 | 0,910 | -0,037 [-0,048; -0,026] | Jev adelante |
| ¿Los tests cubren el cambio? | 2.000 | 0,921 | 0,879 | +0,036 [+0,025; +0,047] | le gana a Jev |
| ¿Introduce una vulnerabilidad? | 597 | 0,904 | 0,755 | +0,139 [+0,108; +0,168] | le gana a Jev |
TS-PRGuard gana en 4 de las 5 preguntas. En breaking changes, Jev va adelante (0,910 frente a 0,870), y preferimos decirlo aquí antes de que lo descubras por tu cuenta.
Qué saber antes de activarlo
- Empieza en shadow mode, a propósito. Comenta en cada pull request y nunca hace fallar ninguno, para que veas sus respuestas en tu propio código antes de que cuenten. Cuando tengan sentido, escribe
mode: enforceen.github/pr-guard.ymly haz obligatorio el statuspr-guard. - Es cuidadoso fuera de lo que se midió. El código en un lenguaje fuera de los 11 de arriba queda marcado como "not evaluated", pide al menos un revisor y nunca entra en auto-merge; la lista es la clave
languagesde la política. Dentro de los 11, la pregunta de vulnerabilidad casi no tiene ejemplos apartados en Kotlin, Swift y Dart, y las descripciones en otros idiomas no se evaluaron. - Vulnerabilidad solo avisa, por defecto. En el benchmark, cada ejemplo apartado es una corrección real de seguridad, una vez como la corrección y otra invertida, así que la mitad (299 de 597) introduce una vulnerabilidad. Ahí, un aviso desde 70% acierta el 90% de las veces, detecta el 91% de los cambios vulnerables, salta en el 9,7% de los seguros y deja pasar el 8,7%. Los pull requests reales casi nunca introducen una vulnerabilidad, así que espera más falsas alarmas: en los 38 pull requests de ejemplo del repositorio, el aviso saltó en 4 de los 28 cambios limpios y detectó 5 de las 10 vulnerabilidades plantadas. Por eso el valor por defecto avisa en lugar de bloquear, y la próxima versión del modelo lo va a mejorar. Si acierta en tu código, agrega
block:a la política. - Decide cuántos revisores, no qué deben encontrar. pr-guard no reemplaza a un revisor.
Entrénalo con tus propios pull requests
TS-PRGuard aprendió de pull requests públicos de muchos proyectos, y es donde pr-guard empieza. Tu equipo tiene sus propias costumbres: qué es sensible, qué rompe a tus clientes, qué necesita tests. El modelo que las conoce es uno entrenado con tus pull requests: en typestrict.ai lo entrenas, medido frente a Jev en tus propios ejemplos apartados, lo publicas en Hugging Face y apuntas la política de pr-guard hacia él:
# .github/pr-guard.yml
model: hf:<owner>/<repo> # $HF_TOKEN for a private repositoryCómo instalarlo
En GitHub Actions, un workflow:
# .github/workflows/pr-guard.yml
on: pull_request
permissions:
  contents: read
  pull-requests: write   # the comment and labels
  statuses: write        # the pr-guard status
jobs:
  pr-guard:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
        with: { fetch-depth: 0 }
      - uses: typestrict-lab/pr-guard@v1
# On your machine
curl -fsSL https://raw.githubusercontent.com/typestrict-lab/pr-guard/main/install.sh | sh
pr-guard check # this branch against its merge base
pr-guard check --staged --no-model # the staged changes, rules only, instantLos otros CIs, las claves de la política y cómo elegir el modelo están en la documentación de PR Guard. El código está en github.com/typestrict-lab/pr-guard y el modelo en huggingface.co/typestrict/TS-PRGuard. Si se equivoca en uno de tus pull requests, cuéntanos: así mejora la próxima versión.