Família TS: modelos de decisão que você treina nos seus dados
Cinco encoders abertos, de 17M a 150M de parâmetros, que escolhem entre opções em vez de escrever texto. Você baixa, roda na CPU e, com a typestrict.ai, treina nos dados da sua empresa.
A maioria das decisões de IA não precisa escrever uma única palavra.
Uma equipe de atendimento precisa escolher uma categoria. Um sistema de pedidos precisa escolher uma rota. Uma operação de risco precisa decidir quais casos merecem revisão. Para essas tarefas, gerar texto palavra por palavra é trabalho a mais: a resposta é uma das opções que você já tem.
Hoje estamos lançando a família TS: encoders abertos que recebem uma pergunta e as suas opções, estimam a probabilidade de cada resposta e podem ser treinados nos dados da sua empresa. Você baixa os modelos no Hugging Face, roda na CPU e usa a typestrict.ai para transformar qualquer um deles num modelo especializado na sua tarefa.
Qual é o assunto da mensagem do cliente?
“Meu cartão ainda não chegou. Como posso acompanhar a entrega?”
- Problema com pagamento<0.1%
- Entrega do cartão100%
- Cancelamento<0.1%
confidence 0.98
Gerar uma resposta ou escolher uma
Um LLM gera texto, um pedaço depois do outro, e alguém ainda precisa transformar esse texto numa das opções. Um modelo de decisão lê a pergunta e todas as opções de uma vez e dá uma nota para cada uma num único passo. Por isso a resposta é sempre uma das opções que você deu, vem com a probabilidade de todas e cabe numa CPU.
choice: escolher uma opção entre várias (o assunto de um chamado, a fila certa, a ferramenta do próximo passo).noul: dizer se uma afirmação é verdadeira (esta cláusula está no contrato? esta resposta usa só o documento?).score: dar uma nota numa escala ordenada (a urgência de um caso, o quanto um produto atende a busca).
Probabilidade e confiança
Cada resposta traz dois números com papéis diferentes. As probabilidades dizem como a resposta se distribui entre as opções. A confiança estima a chance de a opção escolhida estar certa, e é ela que você usa para decidir o que automatizar e o que mandar para uma pessoa.
Dizer que a confiança é calibrada só vale com medida. Na TS-moBERTo-150M ela passa por um ajuste (uma temperatura por tipo de pergunta e número de opções, e um mapa de Platt) feito em metade dos conjuntos de teste de decisões tipadas. Na outra metade, que não entrou no ajuste, o erro esperado de calibração é 0,046 em inglês (1.000 itens) e 0,050 em português (947 itens), contra 0,107 e 0,106 sem o ajuste. Isso vale para perguntas parecidas com as do treino. No seu domínio, meça de novo: é o que a typestrict.ai faz com o seu modelo treinado, olhando a acurácia nas 80% respostas mais confiantes.
Três coisas juntas
- Um encoder especializado em decisões. Pré-treinado em dois estágios (2.048 e depois 8.192 tokens) com dados públicos de licença comercial, para responder
choice,noulescore. - Um modelo aberto. Pesos, ONNX e código de inferência sob Apache-2.0: você baixa, roda onde quiser e não paga por chamada.
- Uma plataforma que adapta e mede. A typestrict.ai treina o modelo nos seus dados e mede o resultado contra uma referência, o Jev, em exemplos que ele não viu no treino.
A família
| Modelo | Tamanho | Idiomas | Decision Index 0.3, encoder sozinho | Hoje |
|---|---|---|---|---|
| TS-moBERTo-150M | 150M | inglês e português | 31,20 | padrão na typestrict.ai |
| TS-Ettin-150M | 150M | inglês | 31,96 | treino na typestrict.ai |
| TS-Ettin-68M | 68M | inglês | 27,61 | treino na typestrict.ai |
| TS-Ettin-32M | 32M | inglês | 19,70 | treino na typestrict.ai |
| TS-Ettin-17M | 17M | inglês | 15,76 | treino na typestrict.ai |
Três medidas, três perguntas
Os números deste lançamento respondem perguntas diferentes, e cada um vem com o modelo e a configuração ao lado: como o encoder se sai sozinho num benchmark público, como ele se sai depois de treinado numa tarefa, e o que acontece na sua tarefa.
1. O encoder sozinho, num benchmark público
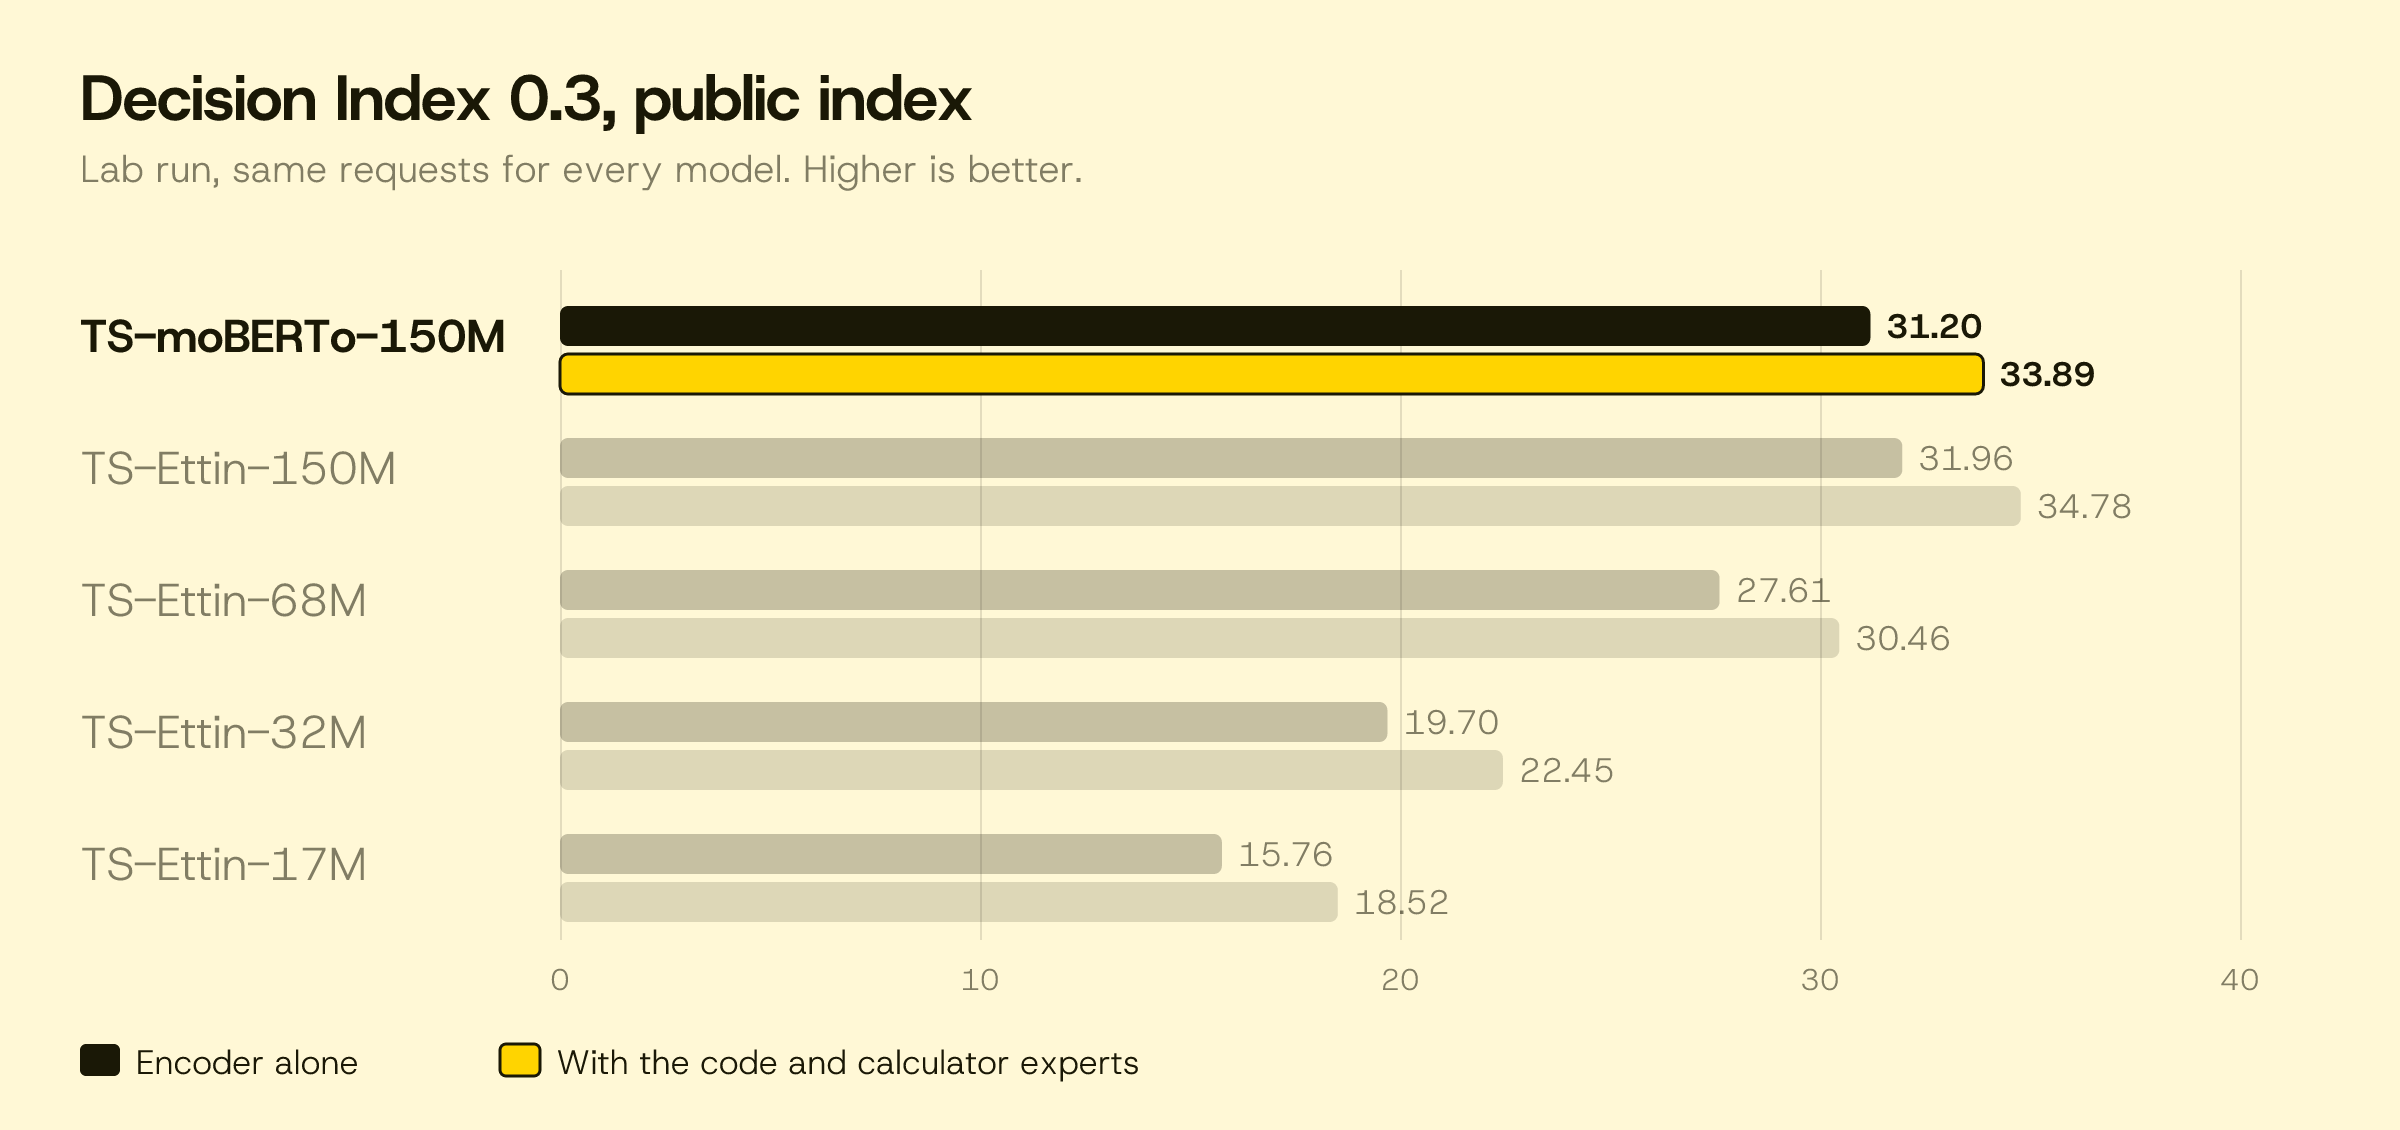
Esse é o retrato do modelo base, antes de ver os seus dados. O pré-treino usa divisões de treino públicas de várias bases que também estão no índice (a lista completa está no card de cada modelo). A corrida oficial do kit do Decision Index na TS-moBERTo-150M, publicada quando ela se chamava Dinah-1, deu 34,32, com os resultados brutos abertos para auditoria. Um encoder de 150M não sabe tudo o que um modelo gigante sabe, e o índice mostra isso com clareza: ele é o ponto de partida, não o produto final.
2. Treinado na tarefa, contra o Jev
Para mostrar o que acontece depois do treino, rodamos o produto como um cliente rodaria em 15 bases públicas: atendimento de banco (BANKING77), seguros, telecom, viagem e crédito imobiliário (Bitext), notícias financeiras, cláusulas de contrato, moderação, segurança de IA e temas de enciclopédia. Em cada uma separamos 20% para teste, treinamos no resto e medimos o Jev nos mesmos 20%.
| Benchmark | moBERTo-150M + fine-tuning | TS-moBERTo-150M + fine-tuning | Jev | Gain over Jev | 95% CI |
|---|---|---|---|---|---|
| BANKING771,001 tests | 0.862 | 0.915 | 0.798 | +11.8 | |
| Bitext Insurance802 tests | 0.986 | 0.991 | 0.896 | +9.5 | |
| Financial news804 tests | 0.812 | 0.824 | 0.743 | +8.1 | |
| Bitext Telco806 tests | 0.994 | 0.991 | 0.911 | +8.0 | |
| Bitext Mortgage814 tests | · | 0.987 | 0.920 | +6.7 | |
| Bitext Travel792 tests | · | 0.984 | 0.952 | +3.2 | |
| Bitext Retail Banking806 tests | · | 0.990 | 0.963 | +2.7 | |
| Measuring Hate Speech (20k)2,000 tests | · | 0.837 | 0.825 | +1.3 | |
| LEDGAR240 tests | · | 0.984 | 0.983 | +0.0 | |
| MINDS-14 (pt)119 tests | · | 0.919 | 0.922 | -0.3 | |
| Measuring Hate Speech800 tests | · | 0.826 | 0.828 | -0.3 | |
| Aegis 2.0800 tests | · | 0.838 | 0.841 | -0.4 | |
| DBpedia798 tests | · | 0.984 | 0.994 | -1.0 | |
| HelpSteer2800 tests | · | 0.683 | 0.739 | -5.7 | |
| SIB-200 (pt)201 tests | · | 0.760 | 0.864 | -10.4 |
Ganho é a TS-moBERTo-150M treinada menos o Jev, em pontos de macro-F1, com o intervalo de 95% por bootstrap pareado. A coluna do moBERTo original só tem número nas 4 bases em que o treinamos do mesmo jeito; nas outras não há resultado comparável. Cada base é um teste separado, sem correção para comparações múltiplas, e as pequenas (MINDS-14 com 119 testes, SIB-200 com 201) têm intervalos mais largos. A regra completa, com a semente fixa e o script para recalcular, está no cálculo de reembolso.
A TS-moBERTo-150M treinada supera o Jev com significância (o intervalo inteiro acima de zero) em 7 das 15 bases, todas com a taxonomia própria do negócio: +11,8 pontos nas 77 intenções do BANKING77, +9,5 em seguros, +8,1 em notícias financeiras, +8,0 em telecom. Em 5 empata e em 3 perde.
3. A sua tarefa
Benchmark público é vitrine. O que vale é a sua tarefa, e nela a regra é a mesma da tabela: a typestrict.ai separa 20% dos seus exemplos, treina no resto e compara com o Jev nos exemplos separados. Se o modelo não superar o Jev pelos critérios publicados, o crédito volta.
Veja decidindo
Abaixo estão exemplos reais do teste do BANKING77: a mensagem do cliente, a resposta da TS-moBERTo-150M treinada e a do Jev, conferidas contra a resposta certa.
“Does my PIN come with my card?”
- typestrictGetting the physical card
- Card arrival
Rápido e pequeno
Na mensagem do exemplo lá em cima, a TS-moBERTo-150M em ONNX int8 levou 30 ms de mediana por decisão na CPU de um Mac com Apple M5, uma decisão por vez. Na geração anterior (Dinah-0), em 200 problemas de xadrez, medimos 63 ms por decisão contra 343 ms do Jev pela API, e 185 ms de mediana no simulador do iOS (iPhone 17), sem servidor.
O modelo inteiro cabe em 164,5 MB. Ele roda no seu servidor, no navegador do seu cliente ou num aplicativo, e cada pergunta não precisa ir para um serviço externo. Depois de baixado, um milhão de decisões custa o mesmo que uma.
Onde o Jev ainda ganha
- Conhecimento de mundo. Em categorias genéricas que um modelo grande já conhece, como os temas da DBpedia e do SIB-200, o Jev venceu.
- Julgamento subjetivo. Avaliar a qualidade de respostas de IA (HelpSteer2) também foi do Jev.
- É um limite dos modelos TS atuais. Novos modelos TS mais fortes nessas áreas estão no laboratório, e até lá é exatamente para esses casos que a garantia existe.
Onde usar
- Atendimento: classifique o assunto e roteie cada chamado para o time certo.
- Jurídico: diga se uma cláusula está presente, ausente ou em conflito com a política da empresa.
- Comércio: decida se um produto atende a busca do cliente, ou se é substituto ou complemento.
- Risco: marque a transação, o e-mail ou a mensagem que merece uma segunda olhada.
- Agentes: escolha a ferramenta certa para o próximo passo, sem pagar um LLM para isso.
- Qualidade de dados: rotule milhares de registros por hora numa única máquina.
Como começar
Baixe e rode
O exemplo do começo, do jeito que rodamos: o código de inferência vem no próprio repositório do modelo.
# pip install huggingface_hub onnxruntime transformers numpy
import importlib.util
from huggingface_hub import hf_hub_download

REPO = "typestrict/TS-moBERTo-150M"
spec = importlib.util.spec_from_file_location("dinah", hf_hub_download(REPO, "dinah.py"))
dinah = importlib.util.module_from_spec(spec)
spec.loader.exec_module(dinah)

model = dinah.DinahONNX.from_pretrained(REPO)  # ONNX int8, CPU
print(model.choice(
    state="Meu cartão ainda não chegou. Como posso acompanhar a entrega?",
    criteria={
        "pagamento": "Problema com um pagamento ou cobrança",
        "entrega_cartao": "Entrega ou envio do cartão",
        "cancelamento": "Cancelar o cartão ou a conta",
    },
    instructions="Qual é o assunto da mensagem do cliente?",
))
# {"choice": "entrega_cartao", "confidence": 0.98, "probabilities": {...}}
Treine nos seus dados
Envie os seus arquivos em typestrict.ai: o agente organiza e anonimiza os dados, você confere a proposta e treina. O treino custa $50 per model ($25 in the launch promotion, until January 18, 2027), e o crédito volta se o modelo não superar o Jev. Também dá para fazer tudo pelo seu assistente de IA, com o servidor MCP, ou pelo CLI. O modelo treinado vem num pacote ONNX que roda no seu servidor, num container ou num app Flutter com o decision_ai.
De Dinah-1 para TS-moBERTo-150M
- Em 14/10/2026 publicamos o modelo como Dinah-1 (revisão
b518a5e7). Em 19/10 ele passou a se chamar TS-moBERTo-150M, na organização typestrict. - Os pesos são idênticos: o mesmo SHA-256 no encoder, no expert de calculadora e nos dois arquivos ONNX. Não houve novo treino.
- Os resultados publicados da Dinah-1, como os 34,32 da corrida oficial do Decision Index, valem para a TS-moBERTo-150M.
- Para projetos novos, use
typestrict/TS-moBERTo-150M. O repositório da Dinah-1 continua no ar, para citações e integrações antigas.
O que vem por aí
Esta é a primeira versão pública da família, e um modelo pequeno não substitui um modelo gigante em tudo. Os próximos passos já estão no laboratório: a calibração das TS-Ettin, mais idiomas, modelos menores para qualquer celular e as arenas abertas para qualquer um testar. Se você tem uma tarefa que gostaria de ver aqui, me conta.
Apêndice: modelos e referências
- [TS-moBERTo-150M](https://huggingface.co/typestrict/TS-moBERTo-150M): base moBERTo, inglês e português.
- [TS-Ettin-150M](https://huggingface.co/typestrict/TS-Ettin-150M), [68M](https://huggingface.co/typestrict/TS-Ettin-68M), [32M](https://huggingface.co/typestrict/TS-Ettin-32M) e [17M](https://huggingface.co/typestrict/TS-Ettin-17M): bases Ettin, inglês.
- Jev:
typesafe/jev-1.13, a referência dos testes e do cálculo de reembolso. - Decision Index: edição 0.3, placar público.